Każda popularna strona ma w internecie swoją historię. Internet Archive od 1996 roku zapisuje kopie witryn, a jego przeglądarka Wayback Machine pozwala je otworzyć tak, jak wyglądały w wybranym dniu. W październiku 2025 roku archiwum przekroczyło bilion zapisanych stron. Sprawdzisz w nim, jak wyglądała oferta konkurencji przed podwyżką, jaki tekst stał na Twojej stronie przed migracją albo co było pod adresem, który dziś zwraca błąd 404.
Ten wpis napisaliśmy w 2019 roku. Od tamtej pory Google wyłączył kopię strony w wynikach wyszukiwania, a Wayback Machine dostał porównywanie wersji i nowe widoki. Dlatego przepisaliśmy go od nowa.
Jak sprawdzić historię strony internetowej w Wayback Machine
Wayback Machine pokazuje historię strony internetowej w trzech kliknięciach i nie wymaga zakładania konta. Wystarczy adres strony.
-
Otwórz web.archive.org
Wpisz w pole wyszukiwania adres strony, np. rewizja.net. Nie musisz podawać https ani www.
-
Wybierz rok na osi czasu
Każdy słupek to liczba kopii z danego okresu. Wyższy słupek oznacza, że robot archiwum odwiedzał stronę częściej.
-
Kliknij dzień w kalendarzu
Dni z kopią mają kolorowe kółko. Im większe kółko, tym więcej kopii z tego dnia. Po najechaniu kursorem zobaczysz godziny zapisów.
-
Przeglądaj stronę z tamtego dnia
Linki w kopii prowadzą do innych zapisanych podstron. Pasek na górze przenosi Cię do wcześniejszych i późniejszych zrzutów.
Tak wygląda kalendarz dla naszej domeny. Archiwum zapisało ją 583 razy, od 27 kwietnia 2007 do 19 lipca 2026.
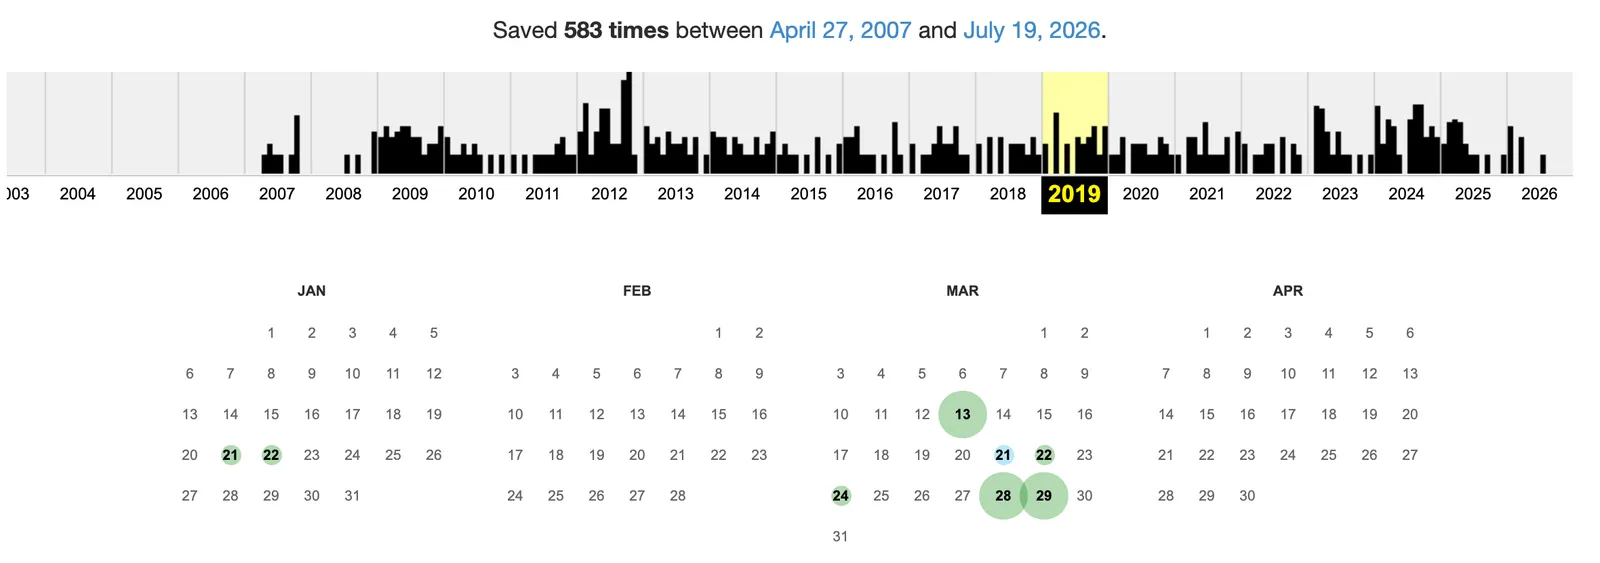
Liczba kopii nie zależy wyłącznie od popularności strony. Liczy się to, czy adres trafił na listy automatycznego zapisu, czy ktoś zapisywał go ręcznie i czy wydawca nie blokuje archiwum. Jeśli zależy Ci na konkretnej dacie, kopię możesz zrobić sam. Opisujemy to w części o zapisie strony na żądanie.
Dlaczego archiwalna wersja strony wygląda inaczej niż oryginał
Archiwalna wersja strony z 10 grudnia 2019 roku to nasza własna strona główna. Tekst jest kompletny, ale układ się rozsypał: zostały nagłówki, lista menu i zwykła czcionka szeryfowa.
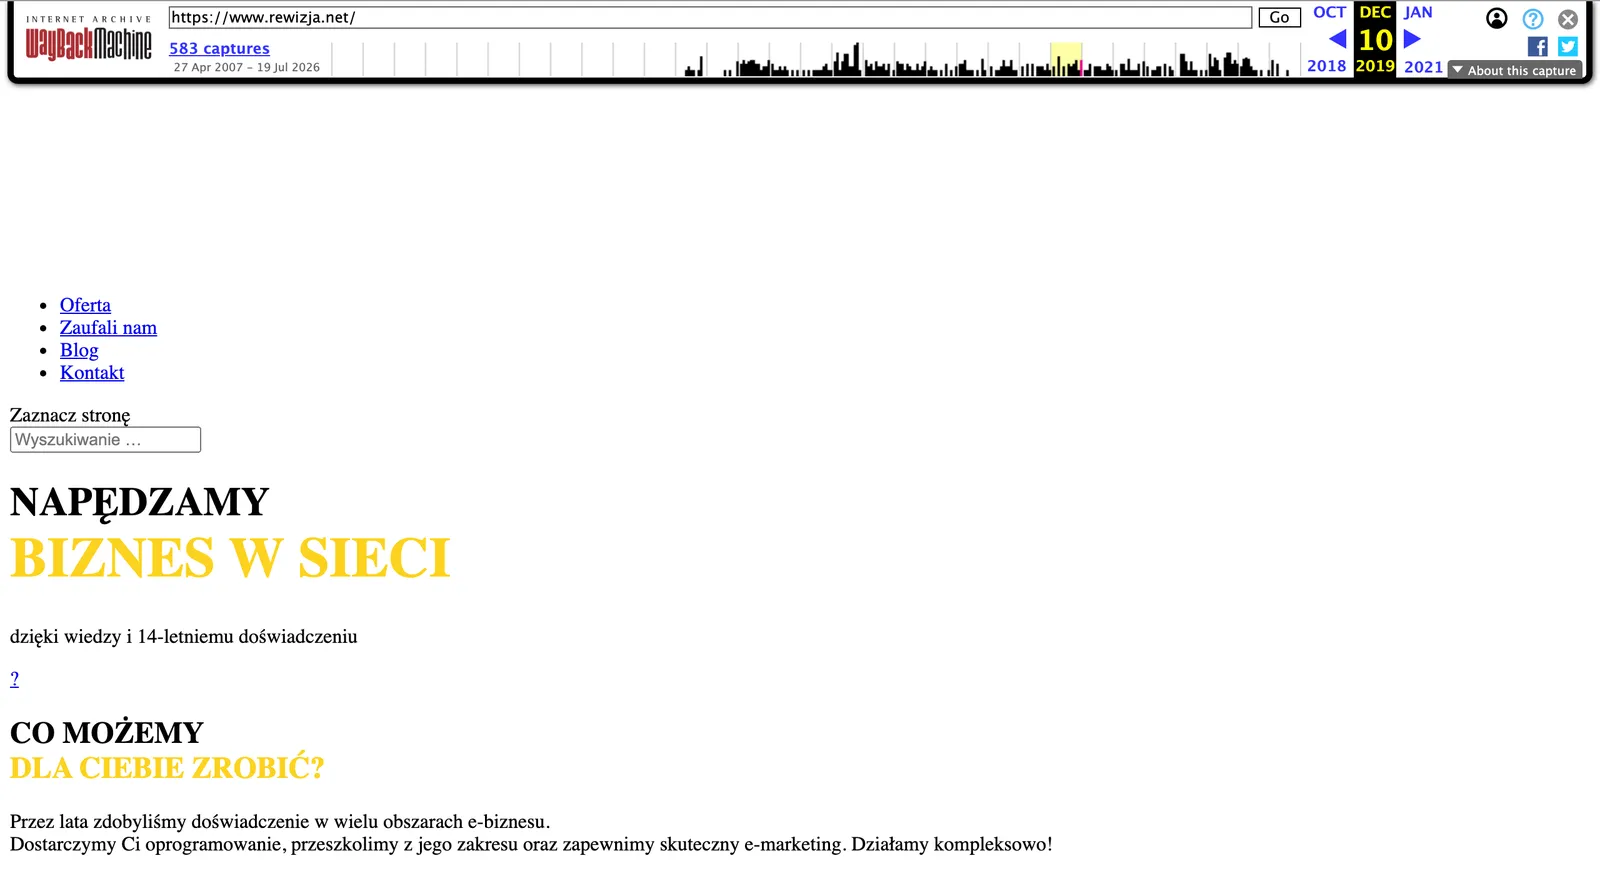
Robot archiwum zapisuje kod strony i pobiera pliki, do których się odwołuje: style, skrypty, grafiki. Archiwum przechowuje także obrazy, ale część plików ściąga innego dnia albo wcale. Wtedy kopia wygląda jak na zrzucie wyżej. Najczęstsze powody:
Dla tekstu to rzadko problem. Treść strony siedzi w kodzie HTML i zapisuje się najpewniej. Gorzej z wyglądem: jeśli chcesz pokazać klientowi, jak wyglądała strona przed zmianami, zrób zrzut ekranu sam, zanim zaczniesz przebudowę.
Jak znaleźć archiwalne strony internetowe bez dokładnego adresu
Wayback Machine pokazuje listę wszystkich zapisanych adresów w domenie, jeśli po nazwie dopiszesz gwiazdkę. Dla naszej domeny wpisujemy rewizja.net/* i dostajemy 4599 adresów z datą pierwszej i ostatniej kopii.
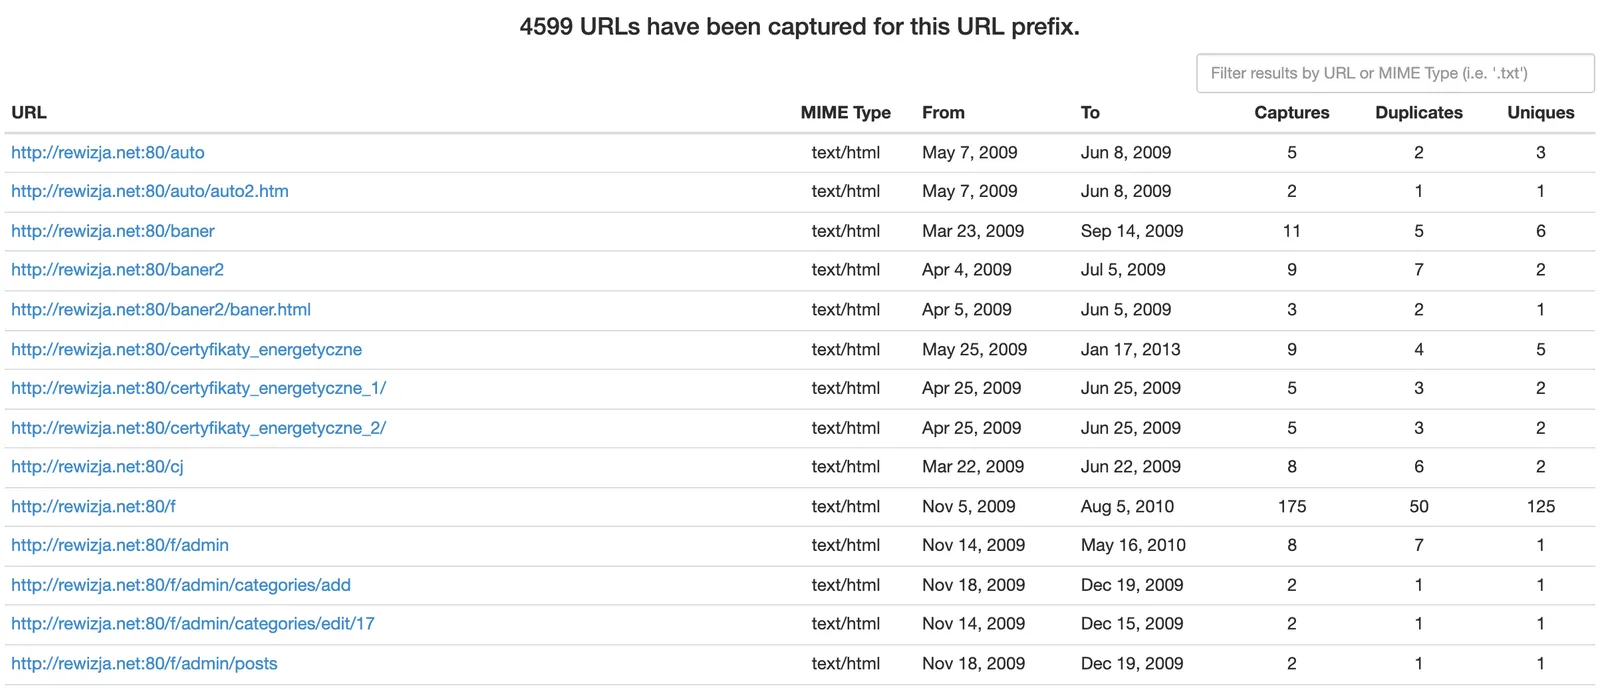
Tak znajdziesz archiwalne strony internetowe, których adresu nie pamiętasz: podstronę starego bloga, regulamin sklepu sprzed lat, ofertę z poprzedniego cennika. W polu nad tabelą wpisz fragment adresu (np. regulamin albo .pdf), żeby zawęzić listę.
Archiwum pokazuje, co było pod adresem kiedyś. To, co z tej domeny jest w Google dziś, sprawdzisz operatorem site: z adresem domeny. Więcej gotowych zapytań znajdziesz we wpisie o operatorach wyszukiwania Google.
Nad wynikami są jeszcze cztery zakładki, które mało kto zauważa:
- Calendar to kalendarz kopii, od którego zaczynasz.
- Changes porównuje dwie wybrane kopie obok siebie i zaznacza na niebiesko i żółto, co się zmieniło. Przydaje się, gdy szukasz dnia, w którym ktoś podmienił cennik albo regulamin.
- Summary i Site Map podsumowują, jakie pliki i podstrony domeny trafiły do archiwum.
Archiwum stron internetowych poza Wayback Machine
Wayback Machine to największe archiwum stron internetowych, ale nie jedyne. Gdy szukanej strony w nim nie ma, warto sprawdzić kolejne miejsca.
| Archiwum | Adres | Do czego się przydaje |
|---|---|---|
| Wayback Machine | web.archive.org | Największy zbiór, kopie od 1996 roku, zapis strony na żądanie |
| archive.today | archive.ph | Zapis pojedynczej strony ze zrzutem ekranu |
| Memento Time Travel | timetravel.mementoweb.org | Jedno zapytanie przeszukuje kilka archiwów naraz |
| Common Crawl | commoncrawl.org | Surowe dane z miliardów stron, dla analityków i programistów |
Do archive.today podchodzimy dziś ostrożnie. W 2026 roku angielska Wikipedia przestała uznawać jego kopie za źródło, a domeny archive.* trafiły na czarną listę projektów Wikimedia. Powodem były m.in. dowody, że treść części zapisanych stron zmieniano.
W Polsce nie ma publicznego archiwum całej domeny .pl. Narodowe Archiwum Cyfrowe prowadzi pilotażowe Archiwum Internetu, ale obejmuje ono strony instytucji z domeny gov.pl.
Co zostało z kopii strony w Google
Kopii strony w Google już nie ma. Na przełomie stycznia i lutego 2024 roku Google usunął z wyników wyszukiwania link „Kopia”, a około 24 września 2024 przestał działać operator cache:. Bing wyłączył swoją kopię pod koniec 2024 roku.
W zamian, od 11 września 2024, Google zaczął pokazywać link do Wayback Machine w panelu „Informacje o tym wyniku”, który otwierasz trzema kropkami obok wyniku.
Szukasz „archiwum Google” albo „kopii strony Google”? Google nie udostępnia już kopii użytkownikom, więc starszą wersję strony znajdziesz w Wayback Machine. Nie myl tego z historią przeglądania: tę zapisuje Twoja przeglądarka i otwierasz ją skrótem Ctrl+H (na Macu Cmd+Y).
Jak samemu zapisać kopię strony w archiwum
Wayback Machine zapisze dowolną publiczną stronę na Twoje żądanie. Kopia dostaje datę i stały adres, który możesz przesłać dalej.
-
Wejdź na web.archive.org/save
Formularz „Save Page Now” jest też na stronie głównej Wayback Machine, w prawym dolnym rogu.
-
Wklej adres strony
Bez konta zapiszesz pojedynczą stronę z grafikami i stylami. Darmowe konto dodaje zapis linków wychodzących, zrzut ekranu i listę Twoich kopii.
-
Kliknij Save Page
Po kilkunastu sekundach dostajesz adres kopii w postaci web.archive.org/web/data/adres-strony.
Kiedy to się przydaje? Gdy konkurencja kopiuje Twoje teksty, gdy sklep zmienia warunki promocji, z której korzystasz, gdy pracujesz nad migracją strony i chcesz mieć punkt odniesienia z dnia przed zmianami. Zapis w niezależnym archiwum ma datę, której nie ustawiasz sam. Urzędy patentowe w USA i Europie przyjmują daty z archive.org jako dowód, że coś było publicznie dostępne. Sądy oceniają takie kopie różnie, a polskiego orzeczenia na ten temat nie znaleźliśmy, więc przy sporze skonsultuj się z prawnikiem.
Do rozszerzenia przeglądarki Wayback Machine (Chrome, Firefox, Edge, Safari) wystarczy jedno kliknięcie, żeby zapisać stronę, na której właśnie jesteś.
Jak odzyskać treść usuniętej strony z archiwum
Z Wayback Machine odzyskasz teksty strony, która przestała działać, nawet jeśli nie masz kopii zapasowej. Kilka razy dostaliśmy właśnie takie zlecenie: odtworzyć stronę klienta po awarii hostingu albo po wygaśnięciu domeny.
Z archiwum zawsze udawało się odzyskać przede wszystkim treści. Grafik bywało różnie: jedne były, innych brakowało. Bazy danych, zamówień i kont klientów nie odzyska nikt, bo archiwum widzi stronę z zewnątrz, tak jak odwiedzający. Mimo to oszczędność w porównaniu z pisaniem wszystkiego od zera była zawsze duża.
Ręczne kopiowanie podstron ma sens przy kilkunastu adresach. Przy większej stronie programiści używają narzędzi, które pobierają wszystkie zapisane pliki domeny, np. otwartoźródłowego Wayback Machine Downloader. Wynikiem są statyczne pliki HTML, bez bazy danych i bez panelu CMS. Trzeba je potem przebudować: poprawić linki, uzupełnić brakujące grafiki, postawić od nowa formularze.
Historia strony w SEO i migracji witryny
Historia strony to dla nas jedno z pierwszych narzędzi przy audycie SEO i przy przenoszeniu witryny na nowy system. Archiwum pokazuje rzeczy, których często nie ma już nigdzie indziej.
-
Stare adresy, które trzeba przekierować
Lista adresów z archiwum pokazuje podstrony, które zniknęły przy poprzedniej przebudowie. Wiele z nich ma jeszcze linki z innych stron, więc każda potrzebuje przekierowania 301 na nowy odpowiednik.
-
Treść sprzed spadku ruchu
Gdy ruch spadł po zmianie strony, porównujemy tytuły, nagłówki i tekst sprzed zmiany i po niej. Często wystarczy jedno spojrzenie na archiwum, żeby zobaczyć, co zniknęło.
-
Historia domeny przed zakupem
Zanim kupisz używaną domenę, sprawdź, co na niej było. Strona z hazardem albo spamem zostawia po sobie linki, których nie chcesz dziedziczyć.
Adresy, tytuły i lata w ramkach to przykłady.
Ruch, który zostawia stara struktura adresów, łatwo stracić przy migracji. Ten wpis jest dobrym przykładem: przez lata żył pod adresem rewizja.net/webarchive-jak-zobaczyc-poprzednia-wersje-strony-internetowej/, a po przeniesieniu bloga stoi pod /blog/. Bez przekierowania 301 cała historia pozycji w Google zaczęłaby się od zera.
Jeśli planujesz przebudowę strony i chcesz przejść przez nią bez utraty ruchu, zajrzyj do naszej usługi audyt SEO.
FAQ
Jak sprawdzić, kiedy powstała strona internetowa?
Otwórz domenę w Wayback Machine i spójrz na datę nad osią czasu: „Saved X times between…”. Pierwsza data to najstarsza kopia, czyli górna granica wieku strony. Datę rejestracji domeny pokaże dodatkowo wyszukiwarka WHOIS, ale domena mogła wcześniej należeć do kogoś innego.
Czym różni się historia strony od historii przeglądania?
Historia strony to archiwalne wersje witryny zapisane przez archiwum internetu. Historia przeglądania to lista stron, które odwiedzasz, zapisana w Twojej przeglądarce (w Chrome skrót Ctrl+H, na Macu Cmd+Y). To dwie różne rzeczy i jedna nie zastąpi drugiej.
Czy korzystanie z Wayback Machine jest darmowe i legalne?
Przeglądanie archiwum jest bezpłatne i nie wymaga konta. Internet Archive to organizacja non-profit z San Francisco. Kopie służą do podglądu i dokumentowania, a ponowne publikowanie cudzych treści z archiwum podlega prawu autorskiemu jak każde inne kopiowanie.
Jak usunąć swoją stronę z Wayback Machine?
Wyślij mail na info@archive.org z listą adresów i okresem, który ma zniknąć z archiwum. Archiwum nie gwarantuje usunięcia. Od 2017 roku sam wpis w pliku robots.txt nie ukrywa automatycznie kopii, które już powstały.
Jak zobaczyć stare wersje Naszej Klasy, Onetu czy YouTube?
Tak samo jak każdej innej strony: wpisz adres w Wayback Machine i wybierz rok. Duże serwisy mają tysiące kopii, ale strony logowania i treści dla zalogowanych użytkowników w archiwum się nie zapisały.
Źródła
- [1] Internet Archive: bilion zarchiwizowanych stron (31.10.2025) blog.archive.org
- [2] Pomoc Internet Archive: korzystanie z Wayback Machine help.archive.org
- [3] Pomoc Internet Archive: zapis stron w Wayback Machine help.archive.org
- [4] Pomoc Internet Archive: usunięcie treści z archiwum help.archive.org
- [5] Internet Archive o robots.txt (2017) blog.archive.org
- [6] Search Engine Land: Google wycofuje link do kopii searchengineland.com
- [7] Search Engine Land: Google dodaje linki do Wayback Machine searchengineland.com
- [8] Search Engine Land: Bing usuwa link do kopii searchengineland.com
- [9] Nieman Lab: wydawcy ograniczają dostęp Internet Archive (05.2026) niemanlab.org
- [10] Wikimedia: archive.today incident meta.wikimedia.org
- [11] Wayback Machine Downloader (GitHub) github.com